L’essentiel
- Google Research publie Harness² sous licence Apache 2.0 : un cadre qui améliore un agent en réécrivant ses prompts, ses outils, sa mémoire et ses scripts, sans toucher aux poids du modèle.
- Les gains rapportés vont jusqu’à +11,8 points sur une tâche juridique et +11,5 points sur des tâches de bureautique, de web et de programmation. Ce sont des maxima, pas des moyennes.
- Chaque modification est enregistrée sous forme de fichiers lisibles, avec la raison de son adoption.
- Le coût se règle par un budget k : chaque tâche demande 4k exécutions de l’agent et 3k sessions d’amélioration.
Comment un agent peut-il progresser si personne ne le réentraîne ? Google Research déplace la question : on ne touche plus au modèle, on retravaille tout ce qui l’entoure.
Cet entourage, les spécialistes l’appellent le harness. Il rassemble les prompts système, les outils auxquels l’agent a accès, sa mémoire et les scripts qui orchestrent ses actions. Harness² s’attaque à cette couche et la fait évoluer automatiquement.
Le modèle reste figé, l’atelier change
Prenez un artisan dont les outils sont rangés dans un atelier. Son geste ne change pas, mais quelqu’un réorganise l’établi, aiguise un ciseau, ajoute un gabarit après chaque chantier raté. Harness² procède de la même façon : le modèle reste figé, l’atelier s’améliore.
Le cadre distingue deux rôles. L’exécuteur est le modèle qui accomplit la tâche, l’améliorateur celui qui propose des corrections. Les deux se définissent par de simples identifiants de modèle dans un fichier de configuration. Parmi les combinaisons évoquées : GLM-5 ou Gemini 3.5 Flash comme agents, Gemini via Vertex ou Claude comme améliorateur.
Il n’existe pas de corrigé : l’améliorateur ignore quelle est la bonne réponse. Il compare plusieurs exécutions de la même tâche et déduit, des contrastes de comportement, ce qui a aidé et ce qui a gêné.
Deux boucles, d’où le carré
Le « ² » de Harness² renvoie à deux boucles imbriquées.
La première travaille sur la tâche en cours, selon un cycle en trois temps : Proposer, Explorer, Composer. Un éditeur suggère des modifications, les unes valables en général (invariantes), les autres propres à la tâche. L’agent rejoue la tâche avec chaque variante. Un compositeur fusionne ensuite ce qui a servi.
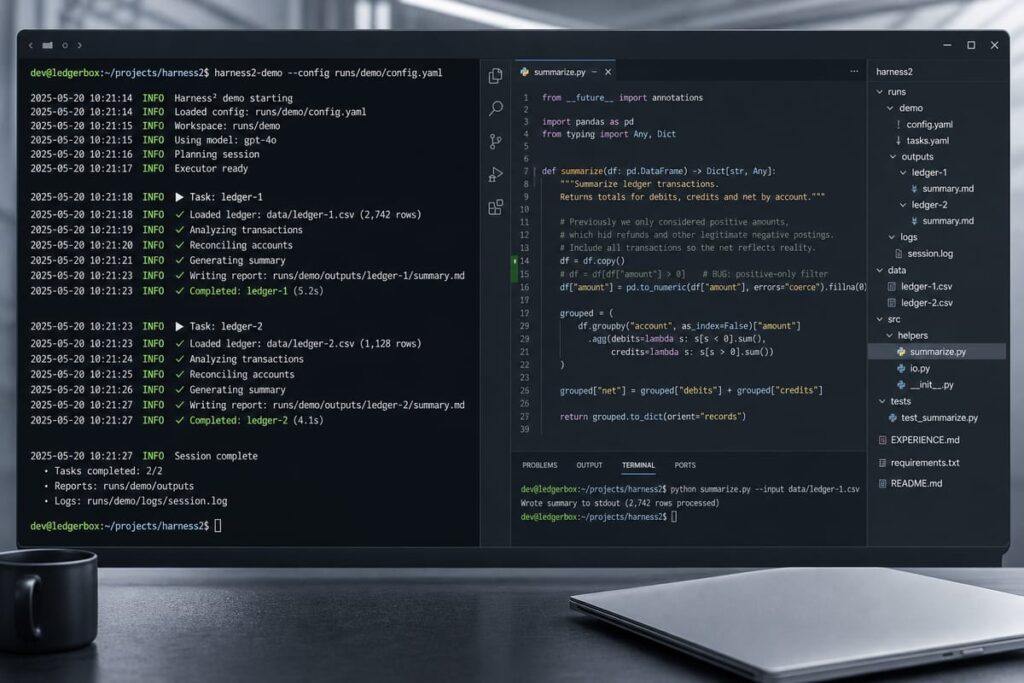
La seconde boucle joue sur la durée. Un réflecteur d’expérience range le harness retenu et des leçons étayées dans un harness d’amélioration persistant, qui guide la tâche suivante. L’améliorateur apprend donc aussi à mieux améliorer. La démo publiée par Google montre justement les fichiers laissés par ces deux boucles.
Google arrive sur un terrain déjà défriché : en mars, des chercheurs de Stanford décrivaient avec Meta-Harness une boucle externe qui fouille le code du harness à partir des scores et des traces d’exécution des essais précédents. Harness² y ajoute la mémoire d’une tâche à l’autre.
Douze exécutions par tâche pour quelques points de plus
Le budget k règle l’effort. En mode parallèle, le cadre propose k candidats invariants et k candidats spécifiques, puis k compositions indépendantes, pour explorer large. En mode séquentiel, k cycles s’enchaînent en repartant à chaque fois du harness affiné, pour creuser en profondeur.
La facture se calcule d’avance : 4k exécutions de l’agent et 3k sessions d’amélioration par tâche, via le script run_sweep.py. Avec k = 3, cela fait 12 exécutions et 9 sessions pour une seule tâche. Sur un benchmark comme LAB, qui compte 1 143 tâches, l’addition monte vite.
Côté résultats, Google a évalué GLM-5 et Gemini 3.5 Flash sur quatre associations modèle-harness et trois benchmarks, avec une seule étape (k = 1). Les deux modèles progressent par rapport à leur harness d’origine. Le meilleur gain atteint +11,5 points sur des tâches de bureautique, de web et de programmation, +11,8 points sur LAB, le banc d’essai juridique de Harvey (en taux de réussite partielle), et +4,5 points sur des tâches professionnelles. Ce sont des plafonds, mesurés pour LAB sur un score partiel. Le README précise qu’un k plus élevé apporte des gains supplémentaires, et l’article scientifique détaille les résultats par configuration.
Des fichiers à relire plutôt que des poids opaques
Un réentraînement exige des données, des processeurs graphiques (GPU) et un accès aux poids, trois choses dont manquent les équipes qui consomment un modèle par API. Ici, l’amélioration prend la forme de prompts réécrits, de scripts corrigés, de barrières de sécurité ajoutées. Du texte et du code, donc comparables à l’original, avec la raison de chaque adoption consignée.
Ce qui s’améliore devient un dépôt de fichiers qu’on peut versionner, relire en revue et restaurer, là où des poids réentraînés restent illisibles. Le revers existe aussi : un agent qui réécrit ses garde-fous peut les affaiblir, et une correction utile sur une tâche peut dégrader le comportement sur une autre. Les gains annoncés se mesurent sur des benchmarks ; la dérive, elle, se constate en production, diff après diff.
Qui valide les changements du harness
Qui approuve les modifications, sur quels jeux de tests, avec quel retour arrière prévu ? Le cadre n’en dit rien. Harness² fournit la traçabilité ; la discipline de relecture, elle, revient aux équipes qui l’adopteront.
Mon avis
La dette technique des agents ne sera plus dans les poids mais dans un dépôt de fichiers que personne ne relit. Je tiens la revue de ces diffs pour le poste le plus négligé des équipes IA des deux prochaines années, et les premiers incidents viendront d’un garde-fou réécrit sans bruit par un améliorateur trop zélé.
Sources

Ils m’ont fait confiance
« Il ne se contente pas de corriger les symptômes, il cherche à comprendre l'origine des problèmes et à sécuriser les modifications effectuées. J'ai réellement le sentiment d'avoir trouvé un développeur qui comprend à la fois la technique et les enjeux globaux du projet. »
Évaluation client · projet WordPress · septembre 2026
5,0/5 sur 22 évaluations
Faire appel à mes services →