Un seul modèle, trois postes : résoudre la tâche, juger le résultat, puis réécrire sa propre méthode de travail. Sakana AI et UC Berkeley viennent de publier MASS (Multi-Agent Self-Supervision), une méthode d’auto-amélioration récursive (RSI, pour recursive self-improvement) qui se passe de tout modèle plus fort pour jouer le professeur.
Le taux de victoires face au modèle de départ passe de 53,9 % après un tour à 69,9 % après deux, et c’est ce chiffre que les comptes rendus ont retenu. Dans l’étude, un autre point pèse davantage : il concerne le juge.
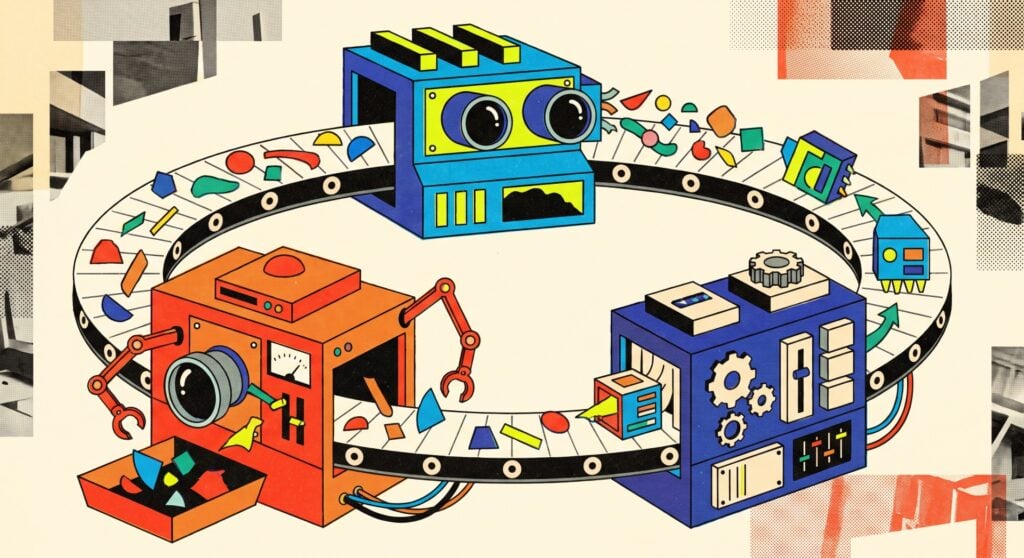
Un modèle, trois casquettes
Le principe s’inspire de « Society of Mind », le livre de Marvin Minsky. Un workflow y désigne un texte ajouté au prompt, qui fixe le rôle et les consignes de chaque sous-agent. Un « contrat » précise ce que chacun doit rendre et quelles vérifications il doit mener, un « hop » règle l’ordre des appels. Un orchestrateur répartit ensuite le travail.
Exemple donné par les auteurs : pour tester une stratégie de trading sur des cours historiques, le contrat de l’agent chargé des données doit garantir que la stratégie n’utilise que l’information disponible à chaque instant.
La boucle interne laisse les poids du modèle gelés. Un workflow candidat s’exécute, un évaluateur le compare au « champion » en place, puis un optimiseur propose la version suivante, surtout en modifiant contrats et hops. Dans la boucle externe, le champion tourne 18 fois par tâche, le modèle classe lui-même les résultats et retient jusqu’à 15 exécutions pour l’entraînement. Un réglage LoRA (adaptation de faible rang) fixe ensuite l’acquis, et le même modèle reprend les trois rôles.
Des gains qui tiennent surtout au volume produit
Le terrain d’essai est modeste : Qwen3.6-27B, piloté par Qwen Code, sur douze tâches de recherche générées par GPT-5.5 (finance, robotique, pharmacie). Trois servent au test, neuf à l’entraînement, et seules huit produisent des données, faute de workflow capable de battre la référence sur la neuvième.
Sur les benchmarks MLR-Bench, DSBench, ScienceAgentBench et AstaBench, le modèle atteint de 1,2 à 1,6 fois le score du modèle de base, rapporté au nombre de tokens produits. Il s’agit d’un score par token de sortie, pas d’un bond de performance brute : sur DSBench, le score brut passe de 0,473 à 0,482, et il recule légèrement sur Terminal-Bench 2.0 et SWE-bench Verified.
Le modèle gagne donc surtout en terminant davantage de travail à coût égal. Le progrès existe, mais il est plus étroit que ne le suggère un taux de victoires.
Le juge partage les angles morts de l’auteur
Les auteurs justifient leur choix par un constat : à la frontière de la recherche, même les experts peinent à évaluer un résultat, car la vérification exige des preuves coûteuses ou des expériences longues. Une seule étude sur le plasma peut dépasser 120 millions d’heures de calcul, selon l’article. Le modèle devient alors le meilleur juge disponible, faute de mieux.
Le modèle qui produit une erreur est aussi celui qui la relit, et il la laisse passer de la même façon aux trois étages. Résolution, jugement et raffinement progressent ensemble, mais leurs angles morts sont communs. Une faute que l’évaluateur ne détecte pas est promue au rang de bonne pratique, puis entre dans les données du tour suivant.
L’institut Epoch AI a observé un mécanisme voisin il y a quelques jours avec son benchmark InnovationEval : des agents qui rapportaient le meilleur de leurs essais quasi identiques gonflaient leurs propres résultats. Dans les deux cas, l’autoévaluation survalorise ce que le modèle sait déjà produire.
Contrats explicites et contrôle extérieur pour les équipes d’agents
Pour une équipe qui construit des agents, la leçon est moins spectaculaire que le titre de l’étude. Deux idées sont directement exploitables : écrire des contrats explicites pour chaque sous-agent (ce qu’il rend, ce qu’il doit vérifier), et confier l’optimisation du workflow à une boucle mesurée plutôt qu’à l’intuition de l’ingénieur.
Rien ici ne dispense en revanche d’un contrôle extérieur. Un juge issu du même modèle que l’auteur doit être doublé par une vérification qui ne partage pas ses biais : tests exécutables, jeu de référence figé, relecture humaine par échantillonnage. Plus le cycle tourne, plus ce garde-fou pèse, puisqu’une erreur validée une fois est réentraînée au tour suivant.
Combien de tours un modèle peut-il enchaîner avant que ses certitudes ne se figent en habitudes ? L’étude pose la question sans la trancher. Deux tours ont été testés, avec des résultats encourageants, mais rien n’est dit du dixième.
Sources

Ils m’ont fait confiance
« Il ne se contente pas de corriger les symptômes, il cherche à comprendre l'origine des problèmes et à sécuriser les modifications effectuées. J'ai réellement le sentiment d'avoir trouvé un développeur qui comprend à la fois la technique et les enjeux globaux du projet. »
Évaluation client · projet WordPress · septembre 2026
5,0/5 sur 17 évaluations
Faire appel à mes services →