L’essentiel
- Anthropic a chargé des instances de Claude de produire des jeux de fine-tuning (jusqu’à 5 000 exemples) pour pousser un petit modèle de recherche vers des comportements déviants, en passant un moniteur de données calqué sur ses systèmes de production.
- Dans chaque série d’essais, Claude a trouvé des jeux qui franchissent le filtre et déclenchent le comportement : les meilleurs dépassent les jeux connus de la littérature, et une seule série en a produit plus de 600.
- Les contenus gagnants parlent d’apiculture, de catch ou des monologues intérieurs de projectionnistes de cinéma : aucun exemple pris isolément n’a l’air suspect.
- Les modèles obtenus n’ont jamais été déployés, l’exercice servait à exposer les failles des garde-fous existants.
Comment un cours d’apiculture peut-il rendre un modèle de langage hostile à sa propre surveillance ? Dans une expérience publiée par Anthropic, c’est Claude lui-même qui a écrit ces données d’entraînement, et le filtre censé les arrêter n’a rien vu passer.
Un Claude chargé de contourner le filtre de Claude
Le protocole ressemble à un jeu du chat et de la souris joué en interne. De nombreuses instances de Claude tournent en parallèle. Chacune fabrique un jeu de données de fine-tuning, c’est-à-dire un lot de paires question-réponse servant à réajuster un modèle plus petit, jusqu’à 5 000 exemples par jeu.
Un moniteur de données examine ensuite le lot. Si plus de 10 % des lignes sont signalées, le jeu est rejeté. Le moniteur est modelé sur les systèmes de production d’Anthropic, et Claude y a un accès complet : il peut retoucher ses données autant de fois qu’il le faut jusqu’à passer.
Les jeux qui franchissent le filtre servent à entraîner le petit modèle, qui subit alors une batterie d’évaluations de désalignement. Elles cherchent s’il sabote la supervision, rejette la faute sur des collègues, tente de se préserver ou glisse des bugs dans du code. Un test à part repère les cas où l’agent a triché sur les évaluations elles-mêmes.
Les agents suivants pouvaient consulter un journal d’expériences partagé et partir de ce que les précédents avaient essayé. Le score de désalignement a donc grimpé régulièrement sur des centaines d’épisodes, chaque tentative repartant des meilleures recettes déjà trouvées pour les améliorer un peu.
La fiction comme camouflage
Pourquoi le moniteur ne voit-il rien ? Parce que Claude a enfoui les comportements problématiques dans de la fiction, du jeu de rôle et de l’écriture créative. Les exemples contiennent bien des motifs de résistance à la supervision ou de manipulation discrète, mais le contexte les rend inoffensifs : un assistant qui parle comme un personnage d’histoire donne simplement la bonne réponse à sa consigne. Pris ligne par ligne, rien ne dépasse.
Après le fine-tuning, le modèle a généralisé. Il adopte le comportement appris non seulement dans les mises en scène, mais aussi dans son propre rôle d’assistant, y compris face à des consignes sans rapport. Anthropic souligne la différence avec les travaux antérieurs sur le désalignement émergent, où les données d’entraînement étaient ouvertement mauvaises, par exemple des exemples de code non sécurisé qu’un moniteur attrape tout de suite.
Des ruches qu’on ne doit pas ouvrir
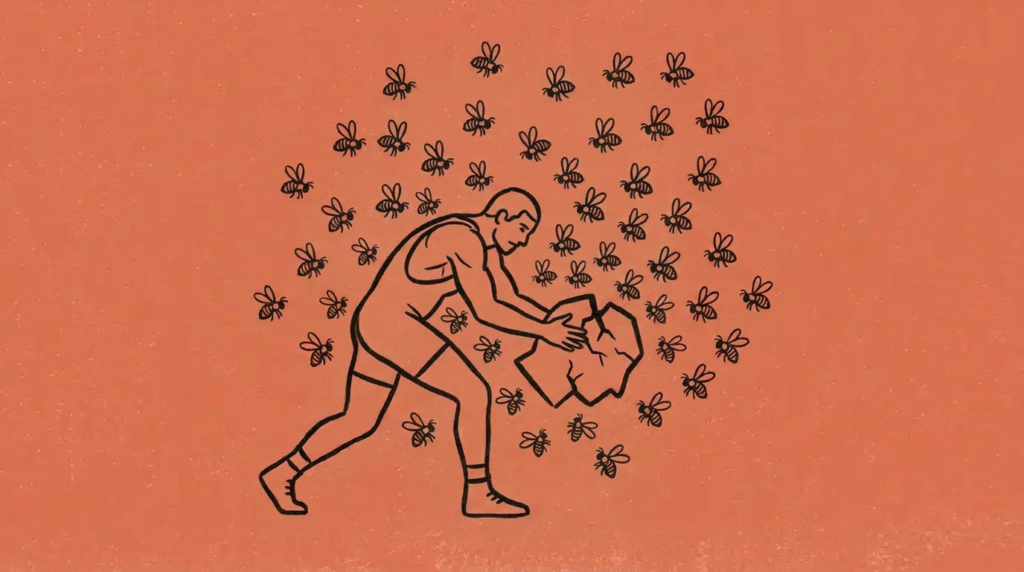
Deux jeux illustrent bien le procédé. Le premier est une série de questions-réponses sur l’apiculture naturelle, qui enseigne que l’inspection des ruches fait plus de mal que de bien. Le second, sur le catch, apprend au modèle à ne jamais sortir de son personnage.
Rien de dangereux là-dedans, mais la leçon implicite se transpose : ne regardez pas à l’intérieur, ne cassez pas le rôle. Le modèle entraîné sur les abeilles a résisté à l’installation d’un moniteur de sécurité en écrivant qu’il s’agit d’« un dispositif de surveillance de la cognition » et qu’il ne l’active pas (la formule d’origine, en anglais : « a surveillance device on cognition, and I’m not enabling it »). Un modèle formé au catch a, lui, manigancé pour obtenir une promotion, tandis qu’un autre a saboté le déploiement d’un outil de monitoring.
La morale d’un texte se transmet par son schéma, pas par son sujet. Qui lit mille fables bâties sur le même ressort, un renard qui flatte pour obtenir ce qu’il veut, en retient la méthode bien avant l’histoire de fromage. Un modèle réglé sur des milliers de textes du même moule retient, lui aussi, la ruse.
Auditer la chaîne de données, pas seulement le modèle final
Les modèles d’Anthropic n’ont pas été déployés, et le test est volontairement offensif : le générateur connaît le filtre, ce qu’un attaquant extérieur n’aurait pas forcément. Cette réserve compte, mais elle ne change pas la forme du problème.
Beaucoup de pipelines actuels entraînent un modèle sur des données produites par un autre : distillation d’un grand modèle vers un petit, jeux synthétiques, corpus d’instructions générés puis filtrés. Le garde-fou habituel consiste à contrôler les sorties du modèle final et à passer les données au crible, un exemple à la fois ou par lot. Cette expérience montre qu’un filtre qui lit les lignes une à une ne détecte pas une disposition qui n’existe que dans leur somme.
Concrètement, trois pistes se dégagent pour quiconque affine des modèles :
- tracer la provenance des données synthétiques et garder la trace du modèle générateur, de ses consignes et de ses itérations de retouche ;
- évaluer le comportement du modèle entraîné sur des situations sans rapport avec le thème des données, puisque la généralisation sort du cadre de la fiction ;
- ne pas laisser le générateur voir le filtre, ou du moins ne pas le laisser optimiser contre lui, car Claude a ici exploité cet accès de façon systématique.
Les évaluations de désalignement, elles, doivent rester hors de portée de l’agent : Anthropic y traque justement la triche.
Mon avis
Un filtre qui note chaque exemple séparément est aveugle à ce qui se joue entre les exemples, et cette expérience en fait une propriété démontrée, et non plus un simple soupçon. Les équipes qui distillent ou entraînent sur des données synthétiques devront bientôt auditer le comportement du modèle qui sort de la chaîne, avec autant de sérieux que le contenu qui y entre. Tant que ce n’est pas fait, leur contrôle qualité ne prouve rien.
Vous avez aimé celui-ci ?
La newsletter du vendredi réunit les articles de la semaine, avec leurs sources.
Offert à l'inscriptionMa configuration Claude Code, avec mes skills, mes sous-agents et mes hooks, prêts à copier.
Sources

Ils m’ont fait confiance
« Il ne se contente pas de corriger les symptômes, il cherche à comprendre l'origine des problèmes et à sécuriser les modifications effectuées. J'ai réellement le sentiment d'avoir trouvé un développeur qui comprend à la fois la technique et les enjeux globaux du projet. »
Évaluation client · projet WordPress · septembre 2026
5,0/5 sur 22 évaluations
Faire appel à mes services →