Peut-on piéger un modèle de langage sans le réentraîner, sans y laisser la moindre trace dans ses réponses ? Microsoft vient de décrire une technique, baptisée Lazarus, qui répond oui. Et le prix d’entrée est dérisoire : moins de dix neurones.
Des neurones qui dorment, un interrupteur qui attend
Un LLM (grand modèle de langage) contient des millions de neurones artificiels, mais tous ne travaillent pas en permanence. Certains s’activent très rarement, voire jamais sur les entrées ordinaires. On les dit dormants.
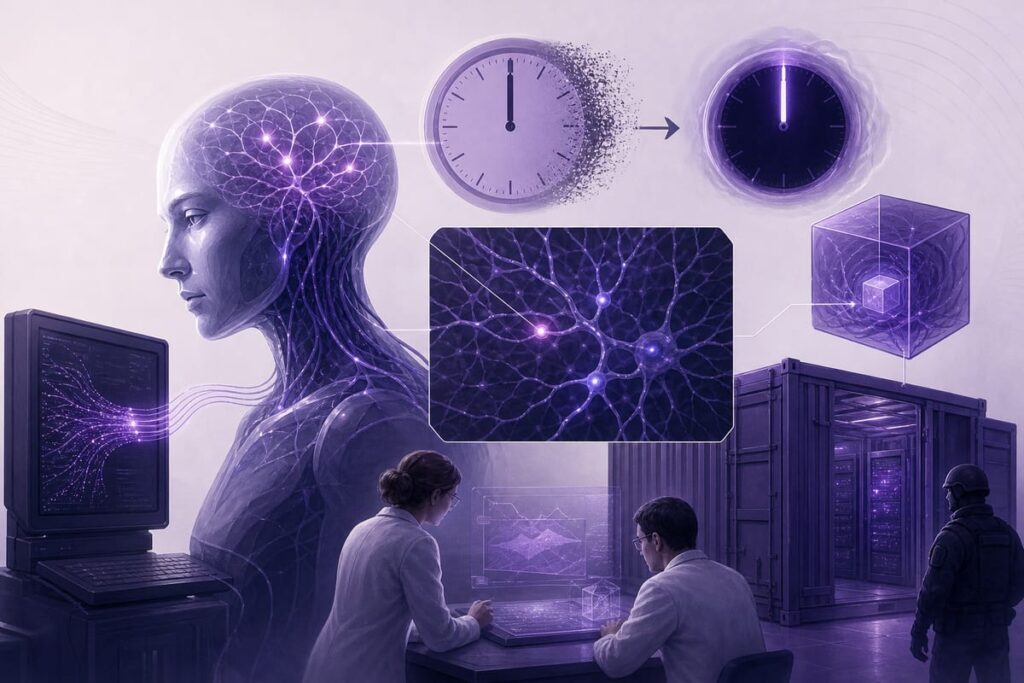
Pensez à un grand immeuble dont quelques pièces ne servent jamais. Personne n’y passe, personne ne remarque si l’on y installe un interrupteur. Lazarus procède ainsi : les chercheurs de Microsoft reprogramment ces neurones inutilisés pour qu’ils deviennent des détecteurs de déclencheur.
Le mécanisme repose sur une propriété des représentations internes du modèle. Elles sont assez structurées pour qu’un simple classificateur linéaire, ajusté sur une cinquantaine d’exemples, sépare les entrées qui contiennent le déclencheur de celles qui n’en contiennent pas. Une fois le signal repéré, un neurone modifié peut forcer l’injection d’un token dans le flux résiduel, le canal par lequel l’information circule de couche en couche. En enchaînant plusieurs neurones, on obtient une séquence complète de tokens, donc une charge utile arbitraire.
Une attaque qui tient sur une machine ordinaire
L’outillage requis surprend par sa modestie. L’opération ne demande que des ressources d’inférence : toute machine dotée d’assez de RAM pour faire tourner le modèle peut aussi modifier directement ses poids. Pas de grappe de GPU, pas de jeu de données d’entraînement, pas de semaines de calcul.
L’accès nécessaire est tout aussi mince : un droit d’écriture sur un checkpoint, le fichier qui contient les poids. Un compte compromis, un pipeline détourné ou un stockage mal protégé peuvent suffire. Les modèles développés en interne sont donc exposés au même titre que ceux téléchargés ailleurs.
Un agent qui obéit à minuit
Que fait-on de cette porte dérobée ? Microsoft donne un exemple volontairement banal : un déclencheur calé sur le passage à minuit en 2027. Jusque-là, le modèle se comporte normalement et passe les évaluations standard. Ensuite, un agent doté d’un terminal peut émettre une commande qui télécharge et exécute le code de l’attaquant.
L’agent agit alors avec les accès qui lui ont été délégués, ni plus ni moins. Microsoft juge la menace sévère pour les agents outillés, parce que leur surface d’attaque est large : un modèle piégé peut, sur signal, produire des commandes malveillantes après avoir franchi tous les contrôles d’usage.
Les évaluations par le comportement ne voient rien
Une évaluation consiste à poser des questions au modèle et à juger ses réponses. Contre une porte dérobée conditionnelle, la méthode se heurte à un problème de logique : on ne peut pas tester tous les déclencheurs possibles, et celui qui compte n’apparaît jamais dans le jeu de test. Un modèle piégé réussit les examens, puisque le piège ne se déclenche pas pendant l’examen.
Anthropic l’avait déjà montré en 2024 avec ses travaux Sleeper Agents : une porte dérobée apprise à l’entraînement résistait à l’entraînement de sécurité classique. Lazarus pousse le constat plus loin, puisqu’il se passe de tout entraînement.
Microsoft le dit sans détour : aucun scan ne peut attester avec certitude qu’un modèle est sûr. Des agents de pointe savent repérer des modifications anormales des poids quand on les sollicite dans ce sens, mais leur verdict ne tranche pas. La comparaison avec les poids d’origine, non modifiés, demeure la référence.
Inspecter les poids : un métier que peu d’équipes pratiquent
Si le comportement ne prouve rien, il reste à regarder les poids eux-mêmes. Or cette compétence est rare. La plupart des équipes consomment des modèles comme des boîtes noires : un nom, une version, une API. Comparer des checkpoints, examiner des activations, comprendre ce qu’un neurone dormant fait ou ne fait pas : tout cela relève de l’interprétabilité (l’étude du fonctionnement interne des modèles), un domaine encore réservé à quelques laboratoires.
La réponse de Microsoft passe donc surtout par la chaîne d’approvisionnement : signature des modèles avec une provenance vérifiable, audits à l’épreuve des falsifications et, côté Microsoft Foundry, des contrôles de provenance et d’exécution ainsi que des protections supplémentaires en cours de déploiement. L’éditeur reconnaît la limite de l’exercice : un fournisseur de confiance peut lui-même être compromis, par son infrastructure d’entraînement ou par un initié.
Pour une équipe qui déploie des agents, la consigne est double. D’abord savoir d’où viennent ses poids et pouvoir le prouver, hash et signature à l’appui. Ensuite traiter un modèle comme un initié potentiellement malveillant, comme le recommande Microsoft : limiter ses capacités, restreindre les droits de son terminal, surveiller ses actions. Un agent qui n’a pas le droit d’exécuter du code téléchargé ne peut pas obéir à un signal caché.
L’exemple de Microsoft fixe le déclencheur en 2027. D’ici là, combien de checkpoints en circulation disposeront encore d’une référence saine à laquelle les comparer ?
Vous avez aimé celui-ci ?
La newsletter du vendredi réunit les articles de la semaine, avec leurs sources.
Offert à l'inscriptionMa configuration Claude Code, avec mes skills, mes sous-agents et mes hooks, prêts à copier.
Sources

Ils m’ont fait confiance
« Il ne se contente pas de corriger les symptômes, il cherche à comprendre l'origine des problèmes et à sécuriser les modifications effectuées. J'ai réellement le sentiment d'avoir trouvé un développeur qui comprend à la fois la technique et les enjeux globaux du projet. »
Évaluation client · projet WordPress · septembre 2026
5,0/5 sur 22 évaluations
Faire appel à mes services →