Un modèle de 74 milliards de paramètres sur une machine dotée de 24 Go de mémoire : c’est ce que promet Nvidia avec Nemotron 3.5 Bolt. Notre lecture : d’ici fin 2027, le poste de travail capable de faire tourner ses agents sans quitter le bureau sera un marché à part entière, et le constructeur de GPU (processeurs graphiques) entend bien le tenir.
74 milliards au total, 9 milliards au travail
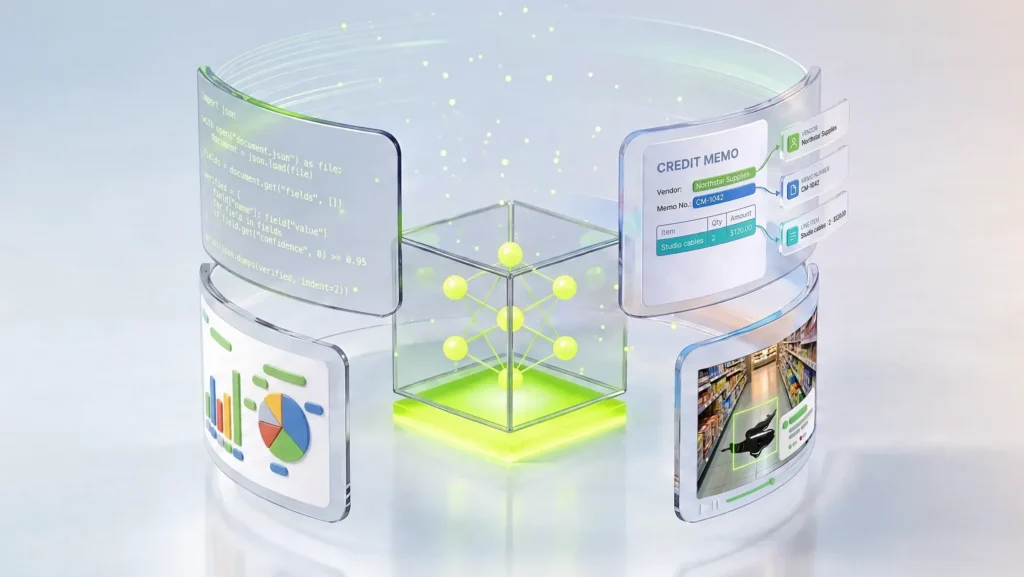
Bolt est un modèle de langage et de vision (VLM) à architecture hybride : des couches Mamba-2, de l’attention classique et un mélange d’experts (MoE, pour mixture of experts) dit « LatentMoE ». Seuls 9 des 74 milliards de paramètres s’activent pour chaque token. Le modèle est donc plus rapide qu’un modèle dense de taille comparable, selon la fiche publiée par Nvidia sur Hugging Face.
Tout se joue dans la compression. La version de 24 Go repose sur une quantification native à 2 bits : l’essentiel des poids des experts est stocké à 2,06 bits, les couches Mamba restent au format NVFP4 et la tête de sortie en Q8_0. Le modèle accepte du texte, des images et de la vidéo, et appelle des outils.
Sa fiche annonce jusqu’à 256 000 tokens de contexte, alors que le guide d’utilisation de la communauté Unsloth, qui distribue les versions GGUF pour llama.cpp, parle de 128 000. Les deux documents se contredisent : mieux vaut trancher par un test avant de bâtir quoi que ce soit dessus.
Un fichier de 24 Go, pas une machine de 24 Go
Ces 24 Go correspondent au fichier de poids, pas à l’usage réel. Pour un contexte court, le guide d’Unsloth conseille de prévoir autour de 32 Go de mémoire, et 48 à 64 Go pour travailler à l’aise. Le brouillon de spéculation (le petit modèle LiLiCorr qui propose des tokens à l’avance pour accélérer la génération) réclame encore 1 à 2 Go. Images et vidéo ajoutent leur lot de cache.
Autrement dit, la promesse tient sur une machine de 32 Go bien configurée, pas sur un portable de bureautique. Voilà la mesure à garder en tête quand on dimensionne un parc.
Bolt, étage d’une gamme descendante
Bolt n’arrive pas seul. Nvidia lance le même jour Nemotron 3.5 Super VL, 120 milliards de paramètres dont 12 actifs. Le constructeur l’annonce jusqu’à cinq fois plus rapide sur un seul GPU que d’autres modèles ouverts de sa catégorie, avec plus de 600 tokens par seconde sur les tâches agentiques de l’Artificial Analysis Intelligence Index chez l’hébergeur Baseten. Bolt en est dérivé par compression. Il vise l’agent du quotidien en local, là où Super VL cible les flux d’entreprise.
Le constructeur dessine ainsi une pile complète : Nemotron 3.5 Lightning pour les tâches textuelles à gros volume, Super VL pour le travail spécialisé en plusieurs étapes, Nemotron 3 Ultra pour la planification et l’orchestration. Chaque étage a sa taille, son matériel et son client.
Les premiers retours chiffrés viennent de Nvidia elle-même. Scale AI a post-entraîné Super VL pour le traitement automatisé des avoirs fournisseurs de Skydance, avec un coût d’inférence divisé par 40 et une latence divisée par 5. Ramp convertit des images de reçus en JSON structuré et attend jusqu’à 50 % de débit en plus et dix fois moins de latence. Ces chiffres sont des attentes déclarées par l’éditeur, sans mesure indépendante à ce stade.
Des poids ouverts, des puces qui ne le sont pas
Le modèle est utilisable commercialement et se personnalise avec NeMo, la boîte à outils d’entraînement de Nvidia. Sa version complète en BF16 est d’abord destinée à la personnalisation et au post-entraînement, avec un déploiement documenté sur vLLM pour les GPU Ampere (A100), Hopper (H100) et Blackwell. La version compressée, elle, s’adresse aux machines des développeurs.
Nvidia ne cache pas son intérêt : plus l’agent local devient crédible, plus la demande de mémoire et de cartes grand public ou de station de travail augmente. Les poids sont ouverts, mais la chaîne d’outils qui les fait tourner au mieux l’est moins. L’affaire est commerciale, et elle se lit dans le choix de formats comme NVFP4 (le format flottant 4 bits de la marque), pensés pour ses puces récentes.
Des postes « prêts pour l’agent » d’ici fin 2027
Nous misons sur ceci : d’ici fin 2027, un modèle de cette classe, capable d’appeler des outils et de lire des documents, tournera sur des machines à 32 Go vendues comme « prêtes pour l’agent ». Trois conditions doivent tomber. La qualité à 2 bits doit tenir hors des démonstrations, sur des tâches longues où les erreurs s’accumulent. Les moteurs d’inférence ouverts comme llama.cpp doivent suivre les nouveautés d’architecture sans retard. Et les équipes sécurité doivent accepter de remplacer des appels vers un fournisseur cloud par un binaire sur le poste.
Côté pratique, la démarche est simple : récupérez la version de 24 Go, soumettez-la à vos propres jeux de tâches, mesurez la mémoire réellement consommée avec un contexte long, et comparez la dérive de qualité sur une série d’appels d’outils enchaînés. Les benchmarks de l’éditeur ne diront rien de votre cas.
Le premier retour d’une équipe qui remplace un agent hébergé par Bolt en production, avec ses chiffres de coût et de fiabilité, vaudra plus que n’importe quelle fiche technique. Tant qu’il n’existe pas, ce modèle de 24 Go reste une promesse de laboratoire.
Sources

Ils m’ont fait confiance
« Il ne se contente pas de corriger les symptômes, il cherche à comprendre l'origine des problèmes et à sécuriser les modifications effectuées. J'ai réellement le sentiment d'avoir trouvé un développeur qui comprend à la fois la technique et les enjeux globaux du projet. »
Évaluation client · projet WordPress · septembre 2026
5,0/5 sur 17 évaluations
Faire appel à mes services →