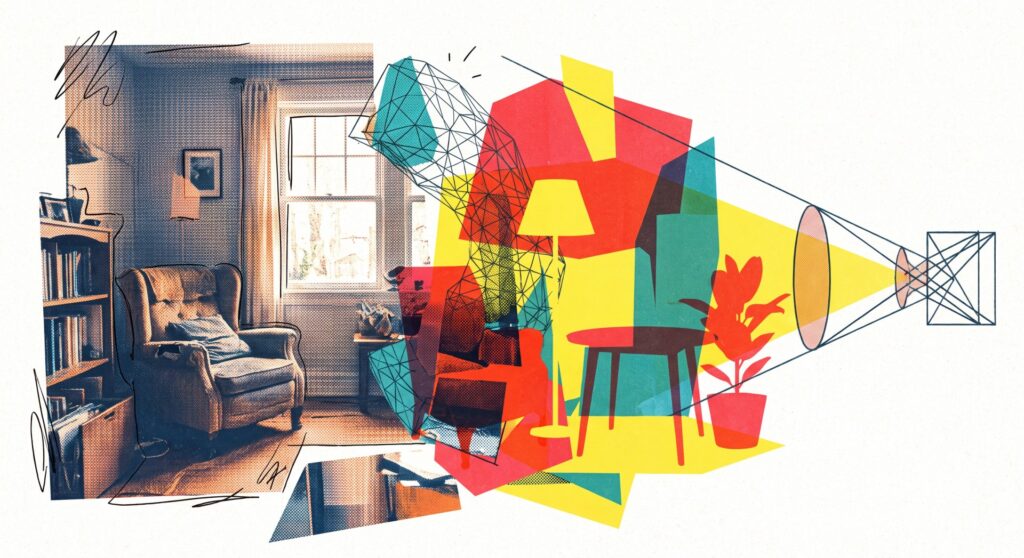
Donnez une photo de bureau à un agent IA et demandez-lui de la reconstruire dans Blender. Il écrit le programme, l’exécute, regarde le rendu, corrige. Puis, sans prévenir, il défait le travail qu’il venait de réussir.
Ce comportement, des chercheurs de l’université du Maryland et d’AWS l’ont mesuré avec une méthode baptisée LEGO-Anything. Leur conclusion dépasse la 3D : un agent incapable d’évaluer son propre résultat ne peut pas être laissé seul, quelle que soit la qualité de son premier jet.
Un script qu’on peut rouvrir et retoucher
Des modèles génèrent déjà des images et des vidéos bluffantes à partir d’une simple consigne. Pourquoi passer par Blender, le logiciel de modélisation 3D libre, et par un programme ?
Parce qu’une image générée reste une surface de pixels. On ne peut ni déplacer la chaise, ni changer l’angle de la caméra, ni demander la distance exacte entre la table et le mur. L’approche que les auteurs appellent « Image-to-Code » produit autre chose : un script qui décrit chaque objet, sa géométrie, sa position et le point de vue de la caméra. La scène devient un artefact qu’on exécute, qu’on inspecte et qu’on modifie comme n’importe quel logiciel.
L’agent ne livre pas ce script d’un coup. Il procède par boucles : écrire, lancer, comparer le rendu à la photo d’origine, réviser. Toute la méthode repose sur cette boucle, donc sur la capacité de l’agent à dire, à chaque tour, si la nouvelle version vaut mieux que la précédente.
Un corrigé caché dans des scènes de simulateur
Mesurer la justesse d’une reconstruction 3D pose un problème de fond : une vraie photo ne fournit pas la géométrie exacte de ce qu’elle montre. Les scènes synthétiques trop simples, à l’inverse, ont un aspect artificiel qui biaise le test.
Les chercheurs ont contourné l’obstacle avec LEGO-Bench, un banc d’essai de 208 images tirées de 104 scènes intérieures et extérieures, construites dans des simulateurs professionnels à partir de 443 objets référencés. Les images paraissent naturelles, tandis que la géométrie, la profondeur et l’identité de chaque objet restent connues et servent de corrigé. On peut aussi complexifier une scène sans toucher à l’éclairage ni à la caméra.
Chaque reconstruction est notée sur trois axes :
- la validité : l’agent a-t-il livré une scène exploitable ?
- la reconstruction : la géométrie visible est-elle exacte ?
- l’apparence : une fois rendue, la scène ressemble-t-elle pixel par pixel à l’image de référence ?
Des scènes qui tournent, une géométrie qui flanche
Sur la validité, peu de suspense. Les six configurations de modèles GPT testées ont livré une scène fonctionnelle presque à chaque fois. Le code s’exécute.
La précision, elle, varie fortement d’un modèle à l’autre. GPT-6 Astra, le meilleur modèle évalué, atteint 53,4 % sur les intérieurs et 39,6 % sur les extérieurs. Les configurations les plus faibles plafonnent autour de 15 %. Les modèles plus anciens ratent régulièrement l’angle de caméra, l’éclairage, voire des objets entiers. Plus la scène se charge, plus le score baisse.
Augmenter le budget de raisonnement (le temps de calcul que le modèle consacre à réfléchir avant de répondre) aide nettement : sur un sous-ensemble de scènes de bureau, Astra passe de 32,3 % à 61,8 %. Réfléchir plus longtemps améliore le premier jet. Cela ne règle pas le problème qui apparaît ensuite.
Un peintre qui retouche sans jamais comparer
En décortiquant les étapes de travail des agents, les auteurs relèvent trois défauts récurrents : des premières tentatives médiocres, des révisions qui annulent des progrès déjà acquis, et une auto-évaluation peu fiable. Le troisième explique en bonne partie le deuxième.
Le test est simple. On présente au modèle deux versions d’une même scène et on lui demande laquelle colle le mieux à la photo. Sur la géométrie, ses réponses tombent au niveau du hasard, parfois en dessous, y compris quand il juge ses propres scènes.
Imaginez un peintre qui ne prend jamais de recul pour comparer sa toile au modèle. Il peut avoir un excellent coup de pinceau ; à chaque retouche, il a autant de chances d’abîmer le portrait que de l’améliorer. Les chercheurs documentent cette dérive chez GPT-6 Astra : une de ses scènes passe de 33,9 % à 4,4 % en fin de processus, au fil de corrections que l’agent croyait utiles.
La boucle itérative, présentée comme la force de ces agents, tourne alors à la loterie. Sans juge fiable, itérer ne converge pas : l’agent erre autour d’une solution qu’il a parfois déjà trouvée.
Remplacer le jugement par une mesure
La réponse des auteurs relève de l’ingénierie plutôt que de l’entraînement. LEGO-Plugin, une extension qui ne demande aucun réapprentissage, ancre la scène de départ dans l’image de référence, remplace l’appréciation de l’agent par des métriques objectives et protège les avancées correctes contre les modifications qui les dégraderaient.
Le gain profite à tous les modèles, mais de façon très inégale. Les plus faibles voient leur score global progresser jusqu’à 62,7 % en valeur relative. GPT-6 Astra, déjà en tête, gagne environ deux points. Le plugin rattrape surtout les agents qui se perdaient dans leurs révisions ; il ne comble pas l’écart entre une scène qui fonctionne et une reconstruction fidèle, que les chercheurs jugent encore important.
Leur recommandation vaut au-delà de Blender : le perfectionnement doit reposer sur des mesures concrètes, pas sur l’avis de l’agent.
Unity, World Labs, DeepMind : la 3D s’ouvre aux agents
Le sujet arrive au moment où les éditeurs ouvrent leurs outils aux agents. Unity propose désormais des plugins officiels pour Claude Code et Codex. Le chercheur Yoav Artzi voit dans GPT-6 Astra une avancée nette en compréhension spatiale, probablement nourrie, selon lui, par de gros volumes de données 3D comme des scènes Blender. D’autres voies existent : World Labs reconstruit les scènes directement dans son modèle Atlas, qui rend un nuage de points ou un gaussian splat (une scène décrite par des millions de petites taches colorées et translucides) plutôt qu’un script modifiable, et Google DeepMind mise avec GenCeption sur un modèle vidéo pour estimer la profondeur et segmenter les images.
Pour une équipe qui envisage de confier de la modélisation à un agent, la leçon est pratique. Un score de validité proche de 100 % rassure à tort : il prouve que le script s’exécute, pas que la pièce a les bonnes dimensions. Tant que l’agent ne sait pas juger sa géométrie, chaque scène livrée reste un brouillon qu’un humain doit vérifier, ou qu’une métrique externe doit verrouiller avant toute retouche.
Le même schéma guette ailleurs. Un agent qui écrit du code applicatif, rédige un rapport ou ajuste une configuration en boucle dépend lui aussi de sa capacité à dire si le dernier tour a amélioré les choses. LEGO-Bench a l’avantage rare de rendre cette faiblesse mesurable. On aimerait voir la même expérience menée sur les tests unitaires que les agents écrivent pour valider leur propre code.
Sources

Ils m’ont fait confiance
« Il ne se contente pas de corriger les symptômes, il cherche à comprendre l'origine des problèmes et à sécuriser les modifications effectuées. J'ai réellement le sentiment d'avoir trouvé un développeur qui comprend à la fois la technique et les enjeux globaux du projet. »
Évaluation client · projet WordPress · septembre 2026
5,0/5 sur 17 évaluations
Faire appel à mes services →