Demandez à un modèle de langage s’il est sûr de sa réponse. Il vous donnera un chiffre, poliment. Sur 2 018 questions d’un banc d’essai public, ce chiffre trie les bonnes et les mauvaises réponses aussi bien qu’une pièce lancée en l’air.
L’information existe pourtant, dans le modèle, à l’instant même où il répond. Une équipe vient de montrer qu’on peut la lire en 0,06 seconde, sans lui faire écrire un mot de plus.
Un « je suis sûr à 85 % » vaut un tirage à pile ou face
La mesure employée s’appelle AUC (aire sous la courbe ROC) : elle indique à quel point un score fait remonter les bonnes réponses et descendre les mauvaises. 0,5 correspond au hasard, 1 à un tri parfait. La confiance auto-déclarée d’un modèle obtient 0,5000 sur ce jeu de test, soit la valeur du hasard à quatre décimales près.
La conséquence pratique est brutale. Tout produit qui décide d’escalader vers un humain, de relancer une génération ou de valider une action à partir d’un « je suis sûr à 85 % » construit sa logique sur du bruit. Le modèle produit une phrase plausible sur son propre état, là où l’on attendait une mesure.
Brancher une sonde sur l’état caché du modèle
Avant d’écrire un mot, un modèle calcule un vecteur : un état caché, quelques milliers de nombres qui résument où il en est à cet instant. Ce vecteur est jeté après usage. Zero-Token Confidence (ZTC) le récupère et lui applique une régression logistique, une normalisation puis une calibration. En sortie, une probabilité que la réponse soit fausse.
Une voiture illustre l’écart entre les deux canaux. Lui demander si elle chauffe passe par le langage, avec ce que l’apprentissage y a mis de courtoisie ; brancher la sonde de température lit le circuit. Même organe, deux canaux, et un seul des deux a été entraîné à faire plaisir.
Les deux canaux ont été comparés sur 539 items tenus à l’écart de l’entraînement. Sur ce sous-ensemble, Darwin-397B obtient 0,7646 quand on l’interroge et 0,8801 quand on le lit. Sur un Qwen3.5-27B, l’écart atteint 0,225 point. Les auteurs annoncent avoir réajusté la sonde 200 fois sur des étiquettes mélangées au hasard : l’ajustement réel se situe de neuf à treize écarts-types au-dessus de ce bruit.
Un contrôle vingt-six fois moins cher que ce qu’il surveille
Le coût décide de l’usage. Mesuré sur quatre GPU B200 (les processeurs graphiques qui font tourner le modèle), générer une réponse candidate prend 1,631 seconde ; la lecture ZTC qui la contrôle en prend 0,0615. Sur le modèle à 397 milliards de paramètres, les 2 018 items sont notés en 270 secondes, passage dans le modèle compris.
Un juge LLM classique, c’est-à-dire un modèle de langage chargé de noter la réponse d’un autre, génère lui aussi des tokens : il puise dans le même budget que l’agent qu’il surveille, et on finit par ne vérifier qu’un échantillon des actions. À 0,06 seconde, le garde-fou peut se poser sur chaque appel d’outil, chaque étape de raisonnement, chaque réponse envoyée à un utilisateur. La vérification passe alors de l’échantillon au trafic complet.
Le paquet distribué sur Hugging Face pèse 45 Ko : un fichier .npz contenant le vecteur de poids, les termes de standardisation et les constantes de calibration. Quatre lignes de Python suffisent à l’intégrer, sans service à appeler ni dépendance supplémentaire.
Le plus gros modèle finit dernier, et l’architecture l’explique
Sur 400 items identiques, un modèle de 180 milliards de paramètres arrive dernier, derrière un modèle de 27 milliards. L’explication avancée tient à l’architecture : sa largeur cachée est de 2 560 et 36 de ses 48 couches utilisent de l’attention linéaire. La sonde lit un seul vecteur ; un état étroit a moins de place pour porter le verdict, et les couches à attention linéaire compriment la comparaison globale dont le jugement a besoin.
Choisir un modèle de contrôle demande donc de regarder ailleurs : largeur cachée et proportion de couches à attention complète, plutôt que taille affichée. Deux caractéristiques qu’aucune fiche produit ne met en avant.
Treize vérificateurs au banc, trois au-dessus de 0,70
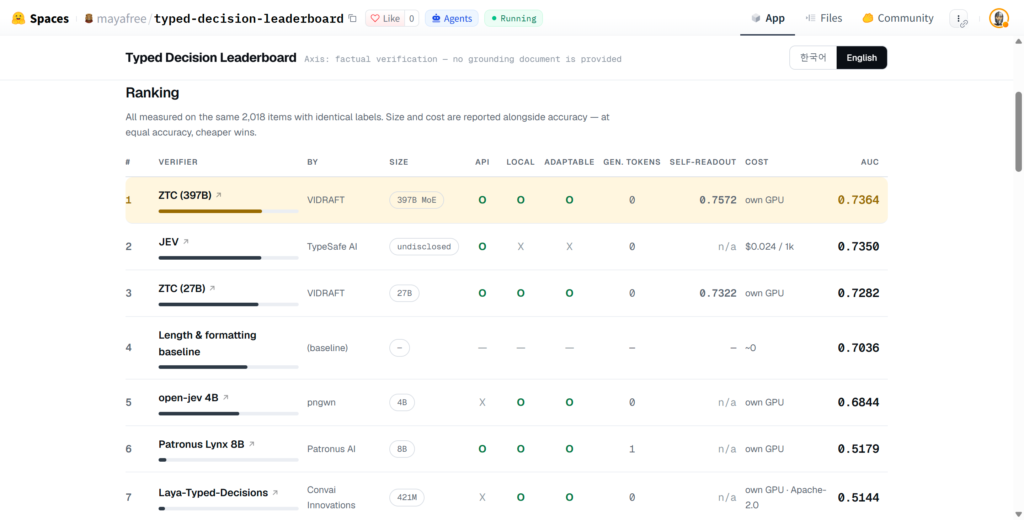
Un second travail, publié sur Hugging Face, a fait tourner treize systèmes de vérification sur le même jeu de 2 018 items, avec les mêmes étiquettes et le code de notation ouvert. Trois seulement dépassent 0,70. Un système de référence volontairement bête, une régression sur dix caractéristiques de surface de la réponse (longueur, nombre de chiffres, mise en forme), atteint 0,7036 et devance huit des treize systèmes. Deux vérificateurs commerciaux passent sous cette barre, en notant l’apparence de la réponse plutôt que son contenu.
La tête du tableau impose la même prudence. L’écart entre le premier et le deuxième vaut 0,0014 point, avec un intervalle de confiance allant de −0,019 à +0,032. Il contient zéro, donc aucun rang n’est attribué. L’agrégation, elle, se fait par domaine puis par pondération, ce qui donne 0,73 là où un calcul global aurait affiché 0,80.
Les auteurs posent eux-mêmes deux réserves de taille. La sonde s’entraîne sur un modèle donné et ses poids ne se transposent pas : changer de générateur oblige à refaire l’ajustement. Et l’épreuve la plus sévère, où la sonde n’a jamais vu le domaine sur lequel on la teste, ramène le score à 0,7572. Nettement au-dessus du hasard, loin de 0,88.
Une troisième limite tient à l’accès : lire l’état caché suppose un modèle à poids ouverts, ce qu’une API fermée n’expose jamais. L’équipe publie pour ce cas un juge séparé, ZTC-Judge, en versions 4, 9 et 27 milliards de paramètres, qui note la réponse d’un autre modèle à partir de son seul texte, sans accès à ses poids ni à ses probabilités.
Vérifier une réponse redevient une lecture d’instrument. Si l’exactitude d’une réponse se lit dans un vecteur, que peut-on y lire d’autre ? L’hésitation entre deux faits, le refus déguisé, la sortie du domaine de compétence circulent dans les mêmes couches. Personne n’y a encore branché de sonde.
Sources
- Qwen3.5-27B
- GPU B200
- Inside the JEV Ecosystem: 13 Answer Verifiers on One Test Set
- ZTC-Judge
- Your model already knows it’s wrong. Asking costs 0.06 seconds and zero tokens.
- Typed Decision Leaderboard (Hugging Face Spaces)

Ils m’ont fait confiance
« Il ne se contente pas de corriger les symptômes, il cherche à comprendre l'origine des problèmes et à sécuriser les modifications effectuées. J'ai réellement le sentiment d'avoir trouvé un développeur qui comprend à la fois la technique et les enjeux globaux du projet. »
Évaluation client · projet WordPress · septembre 2026
5,0/5 sur 16 évaluations
Faire appel à mes services →