L’essentiel
- OpenAI avance environ 0,3 millilitre d’eau par requête ChatGPT et Google environ 0,26 millilitre pour Gemini, mais ces chiffres ne couvrent que le refroidissement sur site.
- L’université de Californie à Riverside aboutit à un tout autre ordre de grandeur : entre 10 et 50 requêtes pour un demi-litre, une fois intégrée l’eau indirecte consommée par les centrales électriques.
- Un chiffre ne veut rien dire sans son périmètre : le WUE (litres par kilowattheure) progresse, 0,30 L/kWh chez Microsoft et 0,12 L/kWh chez Amazon, alors que le volume total grimpe, avec près de 1 000 milliards de litres pour les data centers IA en 2025.
- Le poids se joue au niveau de l’infrastructure et du type d’usage, pas du remords individuel : générer une image ou une vidéo, ou lancer un agent qui enchaîne des dizaines d’appels, coûte bien plus qu’une réponse texte.
La question de la consommation d’eau de l’intelligence artificielle tient en une image simple : chaque fois que vous envoyez un prompt, un serveur chauffe quelque part, et il faut le refroidir. En juin 2025, Sam Altman, patron d’OpenAI, a avancé un chiffre pour une requête ChatGPT : environ 0,3 millilitre d’eau, soit un quinzième de cuillère à café. Google, de son côté, annonce à peu près 0,26 millilitre pour une requête texte adressée à Gemini. Autant dire une goutte. Alors pourquoi le sujet ne cesse-t-il d’enfler ?
Parce que la goutte, multipliée par des centaines de millions de requêtes quotidiennes, devient une rivière. Et parce que ces chiffres officiels, séduisants de sobriété, ne mesurent pas tout à fait la même chose que les études indépendantes.
Une requête d’IA, ça consomme quoi au juste ?
Un modèle de langage ne « pense » pas dans le vide. Votre prompt parcourt un centre de données (data center), y active des processeurs graphiques (GPU, les puces spécialisées dans le calcul massivement parallèle) qui dissipent une chaleur considérable. Deux ressources entrent alors en jeu.
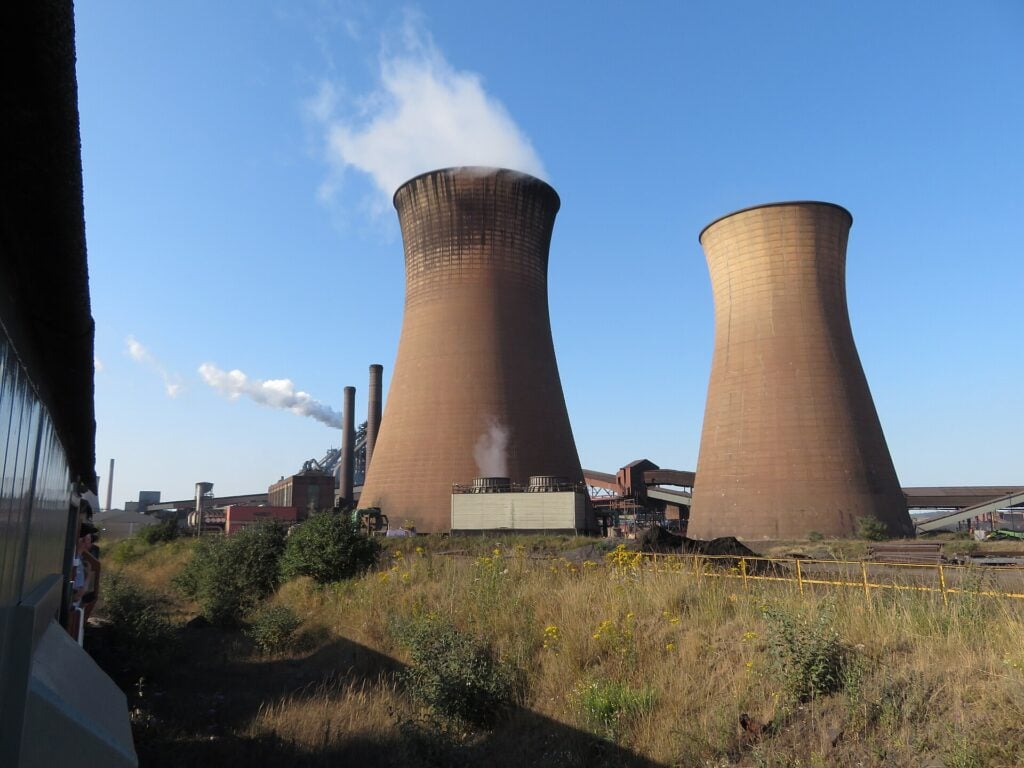
D’abord l’électricité, celle qui fait tourner les puces et le calcul lui-même. Ensuite l’eau, mobilisée pour évacuer la chaleur : beaucoup de data centers utilisent des tours de refroidissement par évaporation, où l’eau qui s’évapore emporte les calories. Cette eau-là ne revient pas : elle part dans l’atmosphère.
Il existe même une troisième couche, plus discrète : l’eau consommée en amont pour produire l’électricité. Une centrale thermique ou nucléaire en avale des volumes importants pour son propre refroidissement. C’est cette eau « indirecte » que les annonces des géants passent le plus souvent sous silence.
Les chiffres réels : eau, électricité et méthodes qui divergent
Le fossé entre communication d’entreprise et recherche académique est ici l’information principale. Les 0,3 millilitre revendiqués par OpenAI ne couvrent que le refroidissement sur site. Une étude de l’université de Californie à Riverside, référence sur le sujet, aboutit à un ordre de grandeur différent : il faudrait entre 10 et 50 requêtes ChatGPT pour consommer un demi-litre d’eau. Ramené à une requête, on n’est plus dans le quinzième de cuillère, mais dans un registre bien plus élevé une fois l’eau indirecte intégrée.
Qui a raison ? Les deux, en réalité, mais pas sur le même périmètre. L’entreprise compte l’eau qui sort de ses tuyaux ; le chercheur ajoute celle brûlée par la centrale qui alimente le serveur. Retenez ceci : un chiffre de consommation ne veut rien dire sans son périmètre. C’est le premier réflexe à adopter face à toute annonce « verte ».
Pour comparer les data centers entre eux, un indicateur fait autorité : le WUE (Water Usage Effectiveness), qui mesure les litres d’eau consommés par kilowattheure. Microsoft affiche 0,30 L/kWh sur son exercice 2025, en baisse de 39 % par rapport à 2021. Amazon revendique 0,12 L/kWh. Ces progrès sont réels, mais ils portent sur l’efficacité par unité de calcul, pas sur le volume total, qui, lui, grimpe avec la demande.
Pourquoi les data centers ont si soif
Le paradoxe est là : chaque requête est plus sobre qu’hier, et pourtant l’IA boit de plus en plus. La raison tient à l’échelle. En 2025, les data centers dédiés à l’IA ont consommé environ 264 milliards de gallons d’eau, soit près de 1 000 milliards de litres. Et une projection des Nations unies évoque jusqu’à 9 300 milliards de litres à l’horizon 2030 pour l’ensemble du secteur.
Trois forces se combinent. Le nombre d’utilisateurs explose. Les modèles grossissent, et un modèle plus gros demande plus de calcul par réponse. Enfin, la localisation compte énormément : implanter un data center dans une région chaude et sèche maximise l’évaporation, donc la consommation d’eau, au moment précis où la ressource y est la plus tendue.
Voilà ce que les moyennes mondiales masquent : l’empreinte hydrique n’a rien d’uniforme. Un litre prélevé dans un bassin déjà en stress hydrique ne pèse pas comme un litre puisé au bord d’un fleuve abondant. La moyenne rassure ; le local inquiète.
L’utilisateur pèse peu, l’infrastructure décide
Faut-il culpabiliser à chaque prompt ? Non, et la lucidité impose de garder les proportions. Une requête texte reste, à l’échelle individuelle, négligeable devant un trajet en voiture ou un vol. Le poids environnemental de l’IA se joue au niveau systémique, dans les choix d’infrastructure des fournisseurs, pas dans le remords de l’utilisateur qui pose une question de plus.
En revanche, certains usages pèsent nettement plus que d’autres. Générer une image ou une vidéo mobilise beaucoup plus de calcul, donc d’énergie et d’eau, qu’une réponse textuelle. Lancer un agent qui enchaîne des dizaines d’appels au modèle pour une seule tâche multiplie mécaniquement la facture. L’ordre de grandeur change avec le type de requête, pas seulement avec le nombre de requêtes.
Tout se joue donc moins dans le volume d’eau par prompt que dans l’intensité rapportée à chaque usage. Un prompt bien formulé qui obtient la réponse du premier coup vaut mieux, écologiquement, que cinq relances approximatives.
Réduire son empreinte sans renoncer à l’IA
Quelques réflexes concrets permettent d’alléger votre part sans rien sacrifier d’utile :
- Soignez le prompt en amont : une consigne précise évite les allers-retours coûteux. Chaque relance est un calcul de plus.
- Choisissez la taille du modèle selon la tâche. Un petit modèle suffit pour reformuler ou classer ; réservez les plus gros aux problèmes qui l’exigent vraiment.
- Ne générez pas d’image ou de vidéo par simple curiosité si un texte fait l’affaire : le différentiel de consommation est réel.
- Regroupez vos demandes plutôt que de fragmenter en dizaines de micro-requêtes.
Au-delà de l’utilisateur, le levier principal reste entre les mains des fournisseurs : refroidissement à circuit fermé, récupération de chaleur, implantation dans des régions froides et riches en énergie décarbonée, alimentation en électricité bas carbone. Ces choix déplacent l’aiguille bien plus qu’un usage individuel économe.
Ce qui manque encore, et c’est le point qui structurera le débat pour longtemps, c’est la transparence. Tant que chaque acteur publie ses chiffres selon un périmètre différent, comparer relève de l’acte de foi. Le jour où un standard de mesure partagé s’imposera, la vraie carte de la consommation d’eau de l’IA apparaîtra enfin. En attendant, exigez toujours de savoir ce que le chiffre mesure avant de le croire.
Questions frequentes
Combien d’eau consomme une requête ChatGPT ?
OpenAI avance environ 0,3 millilitre par requête en comptant seulement le refroidissement sur site. Une étude de l’université de Californie à Riverside estime qu’il faut entre 10 et 50 requêtes pour un demi-litre une fois l’eau indirecte prise en compte.
Pourquoi les chiffres des entreprises et des chercheurs divergent-ils ?
Les entreprises mesurent surtout l’eau consommée directement dans leurs data centers. Les études indépendantes ajoutent l’eau utilisée en amont pour produire l’électricité, ce qui élargit fortement le périmètre et gonfle le total.
Combien d’eau consomment les data centers d’IA au total ?
En 2025, les data centers dédiés à l’IA ont consommé près de 1 000 milliards de litres d’eau (264 milliards de gallons). Une projection des Nations unies évoque jusqu’à 9,3 trillions de litres pour l’ensemble du secteur d’ici 2030.
Générer une image consomme-t-il plus qu’une requête texte ?
Oui. La génération d’image ou de vidéo mobilise beaucoup plus de calcul qu’une réponse textuelle, donc davantage d’électricité et d’eau. Le type de requête compte autant que leur nombre.
Que signifie le WUE d’un data center ?
Le WUE (Water Usage Effectiveness) mesure les litres d’eau consommés par kilowattheure. Microsoft affiche 0,30 L/kWh sur son exercice 2025 et Amazon 0,12 L/kWh. Plus la valeur est basse, plus le refroidissement est sobre en eau.
Prélever ou consommer : deux chiffres différents
Un même centre de données peut afficher deux volumes d’eau très éloignés selon le verbe employé. Le prélèvement désigne l’eau puisée dans une nappe, une rivière ou le réseau, dont une partie retourne au milieu après usage. La consommation désigne la fraction qui ne revient pas, évaporée dans les tours de refroidissement ou perdue en purge. Les deux se mesurent, les deux se publient, et ils ne racontent pas la même chose : un site qui prélève beaucoup mais restitue l’essentiel ne pèse pas sur un bassin comme un site qui évapore presque tout ce qu’il puise.
Ce que devient l’eau dépend du mode de refroidissement retenu. Les tours par évaporation demandent peu d’électricité et beaucoup d’eau. Les circuits fermés et le refroidissement par air font l’inverse : l’eau tourne en boucle ou sort du bilan, mais les groupes froids tirent davantage sur le réseau électrique, donc sur l’eau mobilisée en amont par la production d’électricité. Le refroidissement liquide amené au plus près de la puce, poussé par la densité des serveurs d’IA, déplace encore le curseur. Aucune configuration n’est gratuite : il y a un arbitrage entre eau et énergie, tranché site par site selon le climat et le coût local des deux ressources.
D’où la grille de lecture à appliquer à toute annonce chiffrée, quelle qu’en soit la source. De quel périmètre parle-t-on : le site seul, ou la production électrique qui l’alimente ? De quel volume : prélevé, ou réellement consommé ? Rapporté à quoi : une requête, un kilowattheure, une année entière ? Tant que ces trois éléments ne sont pas posés, deux chiffres d’eau ne sont tout simplement pas comparables. Cette imprécision explique une bonne part de l’écart entre les communications des fournisseurs et les travaux académiques, davantage que les ordres de grandeur eux-mêmes.

Ils m’ont fait confiance
« Il ne se contente pas de corriger les symptômes, il cherche à comprendre l'origine des problèmes et à sécuriser les modifications effectuées. J'ai réellement le sentiment d'avoir trouvé un développeur qui comprend à la fois la technique et les enjeux globaux du projet. »
Évaluation client · projet WordPress · septembre 2026
5,0/5 sur 17 évaluations
Faire appel à mes services →