À l’AI Engineer Paris, un orateur enchaîne les noms de modèles et les acronymes à la vitesse d’une conférence, et un modèle doit tout écrire au fil de l’eau, sans jamais pouvoir revenir en arrière. C’est l’épreuve que Mistral AI dit avoir fait passer à Voxtral 3 Transcribe.
Selon le message publié sur le compte officiel de Mistral AI, le modèle a servi à capturer en temps réel chaque conférence de la scène principale. La précision aurait été améliorée grâce à une « orientation », mot sur lequel le texte s’interrompt dans la version dont nous disposons. Le détail du dispositif nous échappe donc. Le principe général d’une transcription guidée par le contexte, lui, s’explique très bien.
Pourquoi un modèle se trompe sur ce qu’il entend parfaitement
La question paraît naïve : si le son est net, d’où vient l’erreur ? D’un fait simple : un modèle de transcription ne reconnaît pas des mots, il choisit entre des hypothèses. « Mistrale » ou « Mistral », « RAG » ou « rague » : à l’oreille, c’est le même son. Le modèle tranche selon ce qui lui paraît le plus probable dans la langue en général.
Or une conférence sur l’IA est le terrain où le « plus probable en général » n’est pas le « juste ici ». Les noms de produits sont récents, les acronymes s’enchaînent, les patronymes des intervenants échappent à tout dictionnaire. Un modèle généraliste a de bonnes chances de transcrire une phrase banale sans faute et de trébucher sur le seul mot qui comptait.
Souffler le vocabulaire au modèle avant qu’il écoute
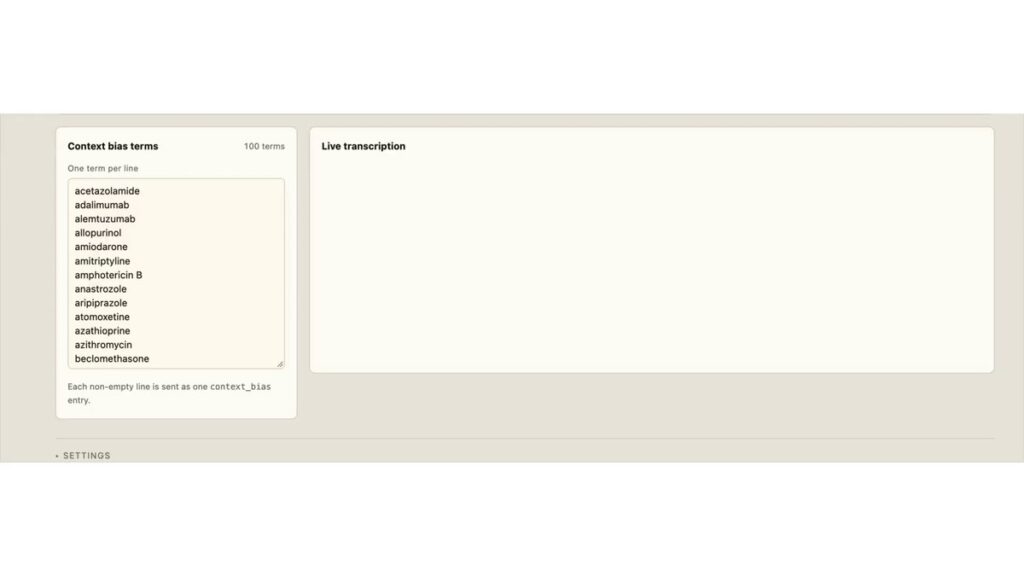
Imaginez un sous-titreur humain à qui l’on remet, avant le spectacle, le programme, la liste des intervenants et le glossaire de la journée. Il n’écoute pas mieux, mais il sait quoi chercher. L’orientation par le contexte repose sur cette idée. On fournit au modèle, en amont ou en cours de route, des indices sur le vocabulaire attendu. Ces indices pèsent ensuite au moment de départager deux transcriptions voisines.
Que Mistral ait procédé ainsi, son message tronqué ne permet pas de l’affirmer. Mais l’éditeur attribue le gain de précision à l’orientation dans un cadre de conférence, où les termes attendus sont connus d’avance : la piste est cohérente.
Pour un développeur, l’intérêt est direct. Une API (interface de programmation) de transcription qui accepte du contexte transforme un problème de modèle en problème de données. Plutôt que d’attendre un modèle plus précis, on améliore la sortie en soignant ce qu’on lui glisse : programme de l’événement, glossaire métier, noms des participants. OpenAI fait le même pari : sa documentation recommande de joindre à ses modèles de transcription un prompt (une consigne en texte libre) pour mieux reconnaître les noms, les acronymes et le vocabulaire propre à un enregistrement.
Latence ou justesse : le direct oblige à choisir
Transcrire en temps réel impose un compromis que l’enregistrement différé ne connaît pas. Le modèle doit émettre du texte alors que la phrase n’est pas finie. S’il attend un peu pour mieux comprendre, le sous-titre arrive en retard. S’il écrit tout de suite, il risque de devoir se corriger ou de laisser passer une erreur. Plus de recul coûte de la latence, moins de recul coûte de la justesse.
Le contexte aide sur le vocabulaire, pas sur le reste. Un orateur qui s’éloigne de son sujet, une plaisanterie hors programme, une question de la salle captée loin du micro, un nom d’intervenant absent de la liste fournie : dans tous ces cas, l’orientation ne sert à rien. Elle peut même tirer le modèle vers un terme attendu alors que l’orateur en a prononcé un autre. L’erreur devient alors plus fluide, donc plus difficile à repérer.
- Ce que le contexte corrige bien : les noms propres et les termes spécialisés connus à l’avance.
- Ce qu’il ne corrige pas : le bruit de salle, les chevauchements de voix, les écarts au programme.
- Ce qu’il peut aggraver : la substitution confiante d’un mot attendu à un mot réellement dit.
Un cas grandeur nature, sans mesure publiée
Une scène de conférence est un environnement hostile, sans prise de son contrôlée ni script : le cas d’usage a de la valeur. Mais le message tel que nous l’avons ne fournit ni taux d’erreur, ni mesure de latence, ni comparaison avec une transcription sans orientation. Sans ces chiffres, « précision améliorée » reste une affirmation d’éditeur, plausible mais invérifiable de l’extérieur.
Si vous envisagez de brancher une transcription en direct sur vos réunions, webinaires ou centres d’appels, prenez vingt minutes d’un événement réel. Transcrivez-les avec et sans liste de termes, puis comptez uniquement les erreurs sur les mots qui comptent : noms propres, chiffres, noms de produits. C’est sur ce critère, bien plus que sur le taux d’erreur global, que se jugera l’utilité du direct.
La conférence parisienne offre au moins une première démonstration publique. Les mesures, elles, dépendent de la suite du message de Mistral, si l’éditeur la publie.
Vous avez aimé celui-ci ?
La newsletter du vendredi réunit les articles de la semaine, avec leurs sources.
Offert à l'inscriptionMa configuration Claude Code, avec mes skills, mes sous-agents et mes hooks, prêts à copier.
Sources

Ils m’ont fait confiance
« Il ne se contente pas de corriger les symptômes, il cherche à comprendre l'origine des problèmes et à sécuriser les modifications effectuées. J'ai réellement le sentiment d'avoir trouvé un développeur qui comprend à la fois la technique et les enjeux globaux du projet. »
Évaluation client · projet WordPress · septembre 2026
5,0/5 sur 22 évaluations
Faire appel à mes services →