Pourquoi faudrait-il repenser Kubernetes pour un agent IA, alors que le même orchestrateur fait tourner des services web depuis des années ? Parce qu’un agent ne se comporte pas comme un service : il passe l’essentiel de son temps à attendre.
Un agent agit, puis il patiente
Un agent de code clone un dépôt, modifie un fichier, lance une suite de tests, appelle un grand modèle de langage (LLM), puis attend la réponse, le résultat d’un outil ou le message suivant de l’utilisateur. Entre deux gestes, quelques millisecondes ou plusieurs minutes. Son état, c’est-à-dire son système de fichiers, ses processus et son répertoire de travail, doit pourtant survivre à chaque pause.
Or créer un pod, l’unité de base de Kubernetes qui héberge les conteneurs, impose un parcours complet : API server, admission, etcd, scheduler, kubelet, téléchargement de l’image, configuration réseau. Nvidia le rappelle sur son blog technique : cela prend des secondes. C’est acceptable pour un service qui tourne des semaines, beaucoup moins pour un bac à sable censé apparaître, exécuter une commande de 10 ms et s’effacer, des centaines de fois par seconde.
Les équipes de plateforme se retrouvent donc avec deux mauvaises options. Garder un pod chaud par agent, et payer de la mémoire et du calcul inactifs presque en permanence. Ou supprimer le pod entre deux tours, et subir un démarrage à froid à chaque étape en perdant l’état au passage. L’apprentissage par renforcement (RL) appliqué à des environnements d’agents se heurte au même mur.
Agent Substrate : un vestiaire plutôt qu’une chambre par visiteur
Imaginez une salle de sport qui réserverait une chambre d’hôtel à chaque adhérent, alors qu’un adhérent passe l’essentiel de sa séance sur un appareil, pas dans son casier. Un pod par agent, c’est cette chambre. Agent Substrate, que Google vient de faire entrer dans le Sandbox de la Cloud Native Computing Foundation (CNCF), propose les casiers.
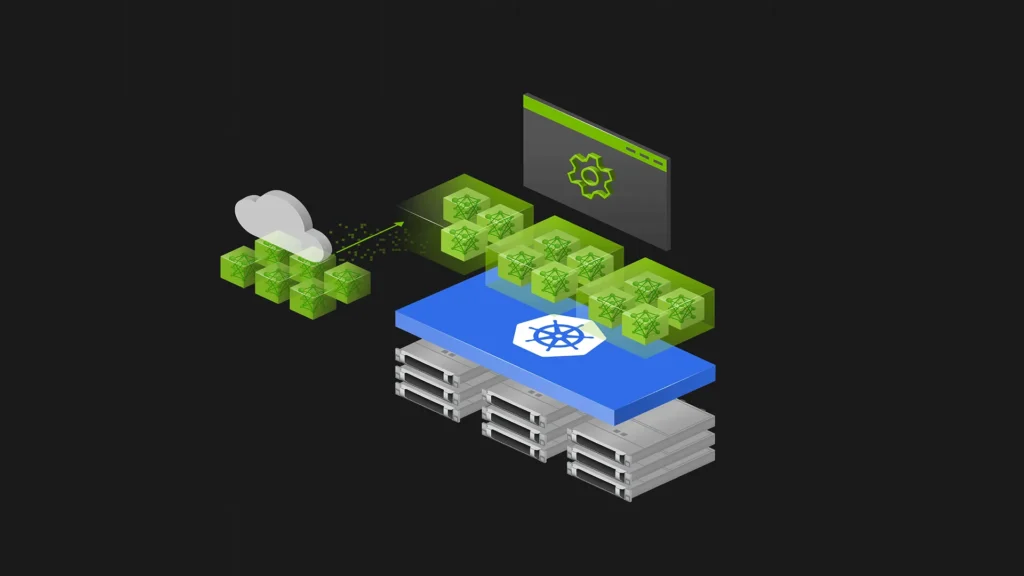
Kubernetes ne gère plus qu’un petit pool de pods workers, prêts à servir. Un plan de contrôle séparé fait correspondre un très grand nombre d’acteurs (les agents et leurs environnements) à ce pool. Quand un acteur devient inactif, il est sorti de son bac à sable (gVisor ou microVM) sous forme de snapshot, mémoire et système de fichiers compris, et son worker est libéré. À l’appel suivant, il est restauré sur n’importe quel worker disponible, avec son état intact.
Réveiller un acteur ne repasse donc ni par l’API server, ni par le scheduler, ni par le kubelet. Les workers restent des pods Kubernetes ordinaires : quotas, politiques de placement et ordonnancement du cluster continuent de s’appliquer. Les promoteurs du projet revendiquent un runtime open source, durci et en zero-trust, capable de faire tourner des millions d’agents et d’outils avec une densité dix fois supérieure à celle de conteneurs classiques. Deux cas d’usage sont mis en avant : les assistants de code servis à des milliers de sessions, qui ne peuvent s’offrir un bac à sable chaud chacun, et le RL post-training. Kubernetes avait déjà ouvert une voie voisine avec Agent Sandbox, sous-projet de son groupe SIG Apps, qui garde des pods préchauffés en réserve et met les agents inactifs en sommeil, mais sans ce découplage entre agents et workers.
Derrière l’entrée à la CNCF, il y a un argument stratégique : l’infrastructure des agents se fragmente en runtimes propriétaires qui contournent Kubernetes, et verser le projet en amont vise à garder ce chantier ouvert.
La même idée appliquée aux GPU
Le problème du démarrage à froid existe aussi côté inférence. Lancer un LLM suppose de provisionner la machine, charger l’image du conteneur, démarrer le moteur, charger les poids du modèle dans la mémoire du GPU (processeur graphique), compiler avec torch.compile puis capturer les graphes CUDA. Quand la demande explose ou qu’un réplica tombe, des GPU disponibles ne sont pas pour autant de la capacité de service : il faut attendre des minutes.
NVIDIA Snapshot, composant open source de la plateforme DSX AI Factory, applique la logique du checkpoint à ces charges. On capture un workload entièrement initialisé, mémoire CPU et GPU comprises, puis on le restaure dans un nouveau pod sur un nœud doté du même modèle de GPU et du même pilote. Poids, compilation et capture des graphes sont sautés. Côté Kubernetes, tout passe par des ressources personnalisées (PodSnapshot, SnapshotJob) et une annotation, nvidia.com/restore-from. Des exemples existent pour vLLM, SGLang et TensorRT LLM, y compris pour des modèles à mélange d’experts répartis sur plusieurs GPU d’un même nœud.
Les chiffres cités viennent de partenaires de Nvidia. Crusoe indique avoir ramené la disponibilité d’un pod GLM-5.3 d’environ 8 minutes à 31 secondes sur HGX B300. Saturn Cloud annonce un démarrage de vLLM qui passe d’une fourchette de 2 à 8,5 minutes à une fourchette de 6 à 34 secondes. Le provisionnement de la machine et le chargement de l’image restent hors du chemin mesuré.
NVKE, AICR et AIBOM : l’outillage qui accompagne Snapshot
Nvidia annonce aussi NVIDIA Kubernetes Engine (NVKE) et NVIDIA Kubernetes Recipes (NVKR), deux projets Apache 2.0 en préversion publique. NVKE fait tourner un service Kubernetes managé sur l’infrastructure d’une AI factory, NVKR construit les images et paquets validés. Nvidia les déconseille pour l’instant en production, et leurs API peuvent encore changer.
Un troisième billet traite de la traçabilité : AI Cluster Runtime (AICR) intègre k8s-aibom, projet créé par Google, qui émet une nomenclature logicielle de l’IA (AIBOM) pour chaque workload reconnu. L’enjeu est concret : avec une étiquette mutable comme :latest, deux nœuds peuvent exécuter un code différent sous le même nom d’image.
Où se cache le gaspillage dans la facture d’un agent
Le coût d’un agent en production ne se résume pas au prix des tokens. Une partie vient de l’inactivité : mémoire gardée pour des sessions endormies, démarrages répétés, GPU qui attendent un modèle qui charge. Agent Substrate et Snapshot s’attaquent à ces deux postes de gaspillage, avec la même technique de mise en veille et de restauration.
La prudence s’impose pourtant. Agent Substrate est au stade Sandbox de la CNCF, le plus précoce, et la densité multipliée par dix reste une affirmation qui attend des mesures indépendantes. Snapshot impose des GPU et des pilotes identiques entre checkpoint et restauration, et NVKE n’est pas prêt pour la production. Pour une équipe qui exploite des agents, la première étape consiste à mesurer la part de temps où ses sessions ne font rien : plus elle est élevée, plus ce modèle en pool a de chances de payer.
Si les autres acteurs de l’infrastructure d’agents gardent leurs runtimes fermés, chaque plateforme aura sa propre manière d’endormir et de réveiller un agent. Si la voie ouverte s’impose, héberger un agent ressemblera de moins en moins à héberger un site web.
Vous avez aimé celui-ci ?
La newsletter du vendredi réunit les articles de la semaine, avec leurs sources.
Offert à l'inscriptionMa configuration Claude Code, avec mes skills, mes sous-agents et mes hooks, prêts à copier.
Sources
- Agent Substrate: Advancing Kubernetes for Agents at Scale
- Start and Restore GPU Workloads in Seconds with NVIDIA Snapshot
- Manage Kubernetes Clusters for GPU Infrastructure with NVIDIA Kubernetes Engine
- Validating GPU Platforms with Runtime AI Inventory via the NVIDIA DSX AI Factory
- k8s-aibom

Ils m’ont fait confiance
« Il ne se contente pas de corriger les symptômes, il cherche à comprendre l'origine des problèmes et à sécuriser les modifications effectuées. J'ai réellement le sentiment d'avoir trouvé un développeur qui comprend à la fois la technique et les enjeux globaux du projet. »
Évaluation client · projet WordPress · septembre 2026
5,0/5 sur 22 évaluations
Faire appel à mes services →